|
|

楼主 |
发表于 2018-10-31 09:49:03
|
显示全部楼层
本帖最后由 5dhtml 于 2018-10-31 09:53 编辑
6 _) n5 ]3 Y3 e7 z/ ?% u$ y w' C! ?3 q1 ]) i3 M
哈哈哈,有意思,你这个思路比较好玩,不知道你是怎么嵌套的,能详细说说吗?6 e1 ]1 s$ l/ A, R2 F
! Y- O6 q9 u! L* N, S4 z
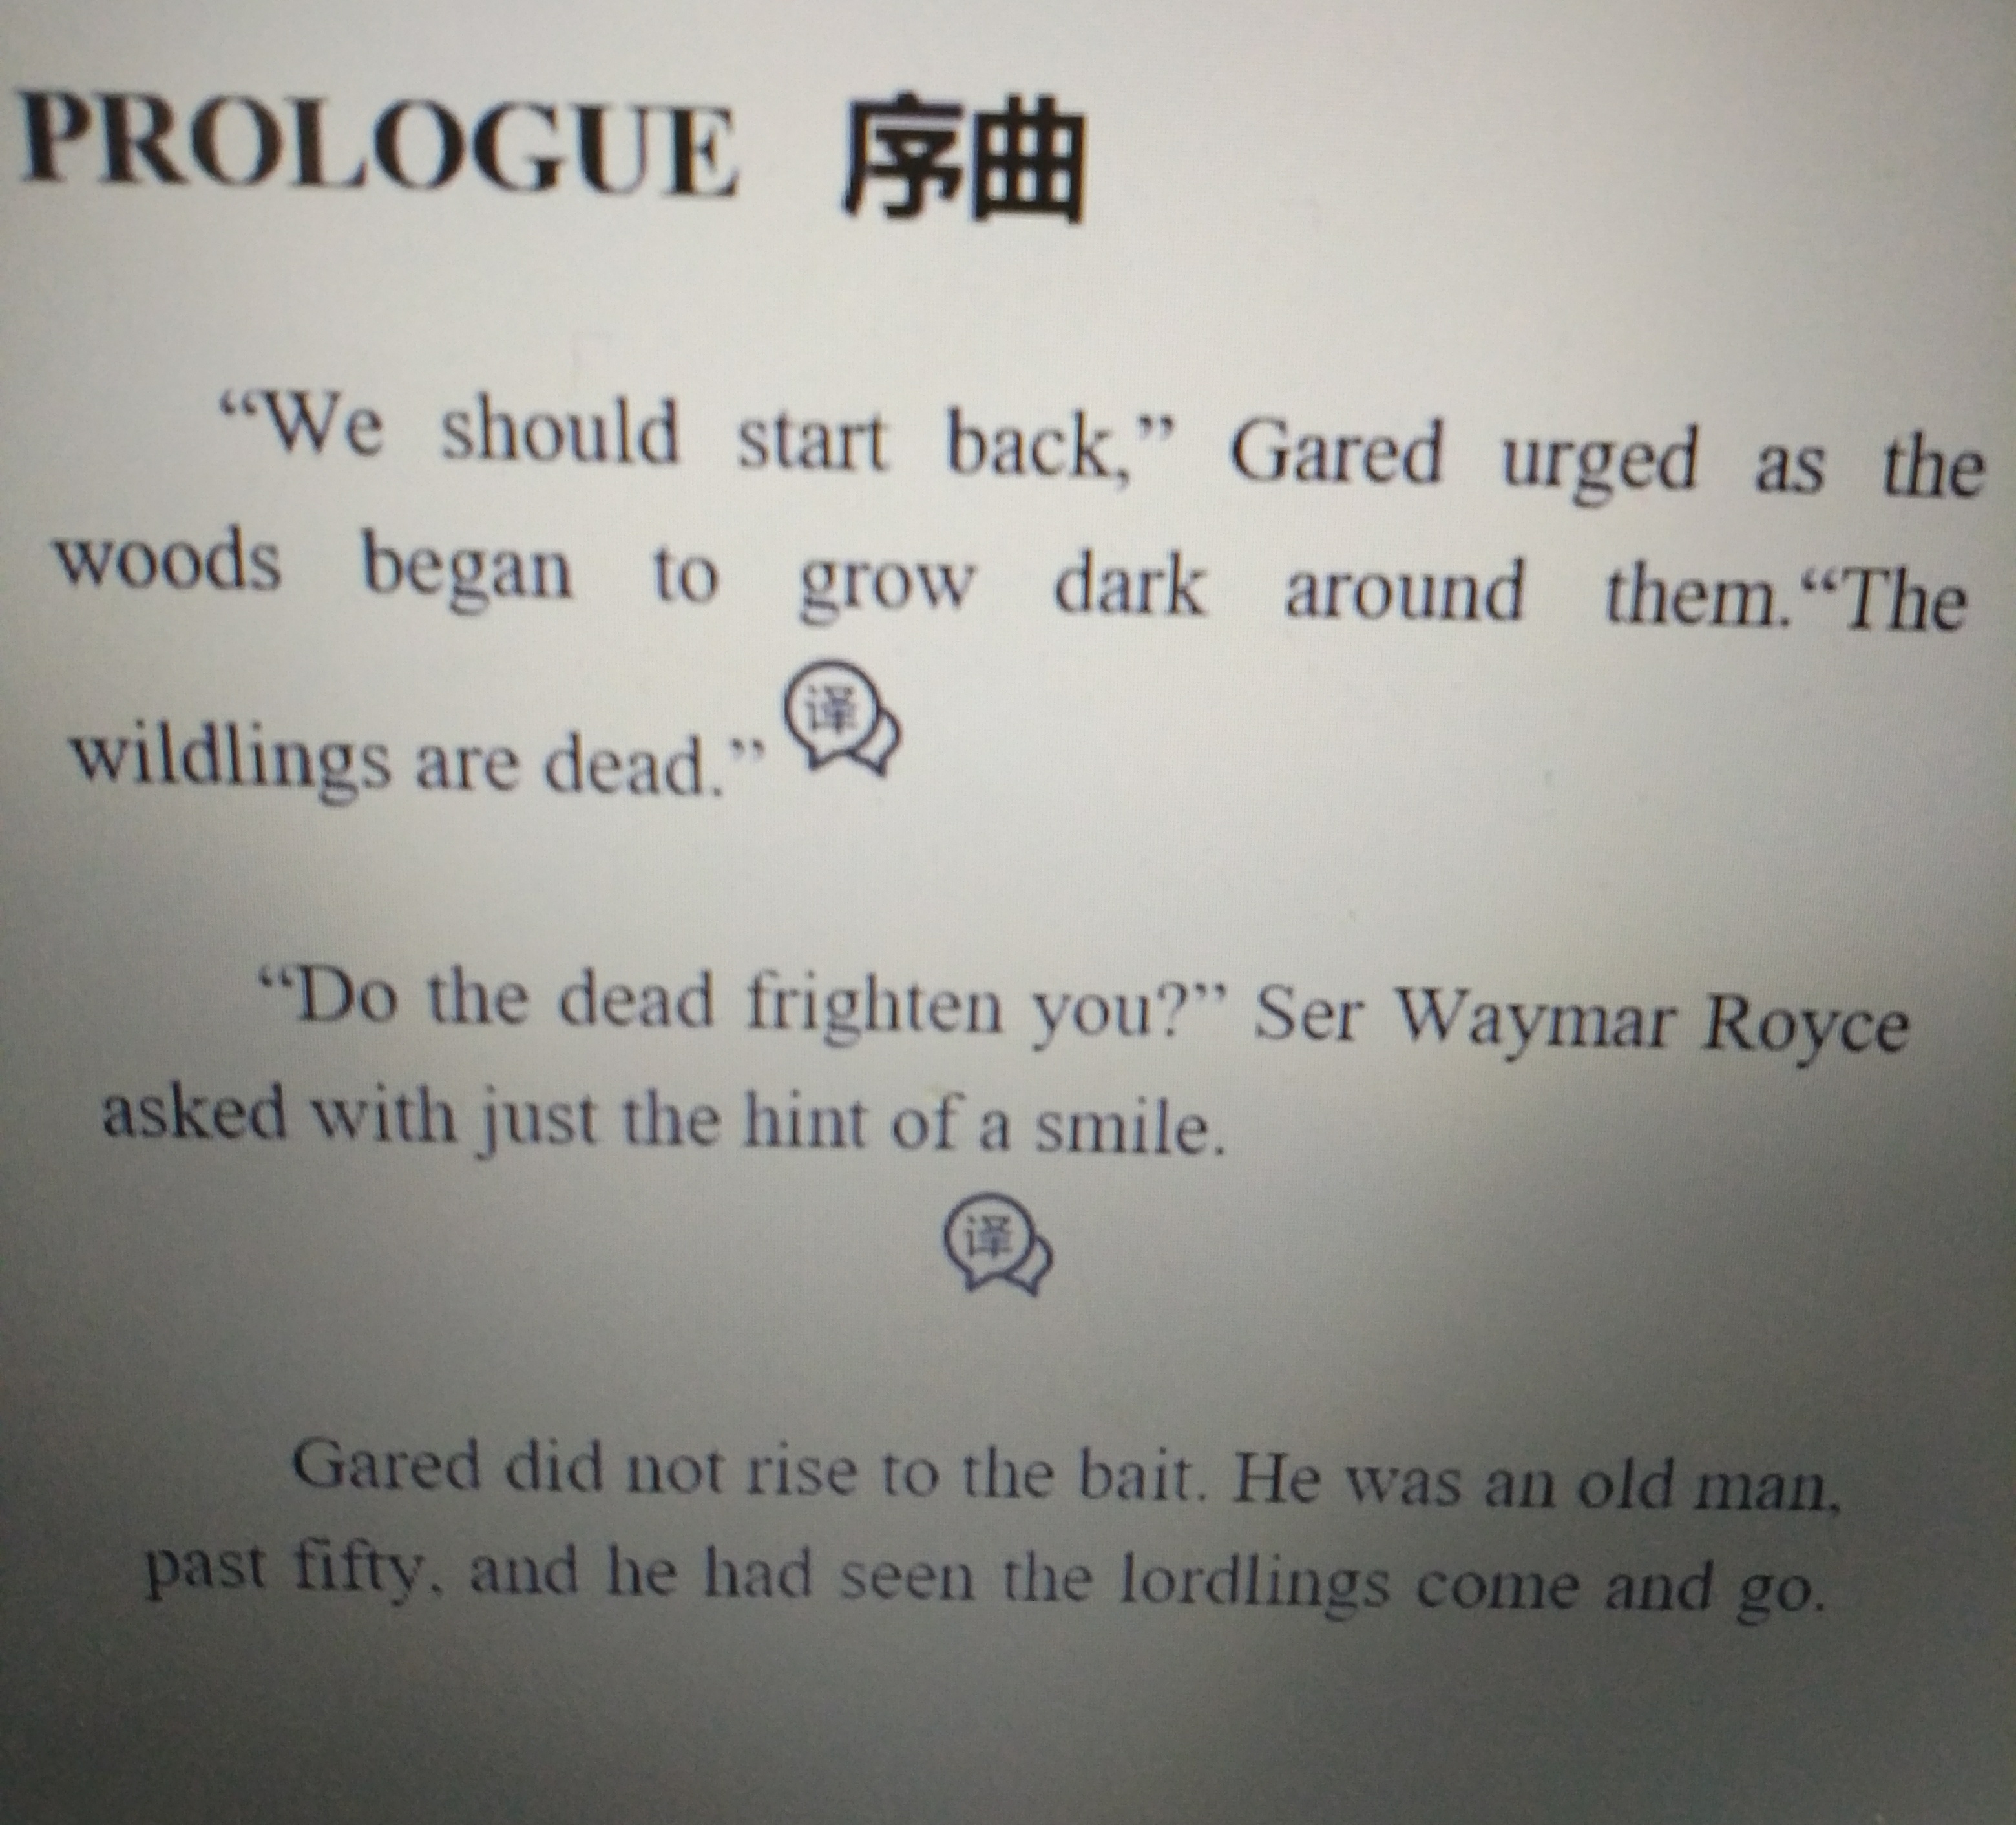
我来说说我以前怎么做中英逐行对照的* `: b, ]1 |* a! O6 ^. O
我是简单的把中英两个版本的正版电子书epub文件转txt,再把两个文本合并,最后打包回epub,方法很简单:
! r: d1 U8 N1 o# L1 n- paste -d '\n' 1.txt 2.txt > 3.txt
前提是中英两个版本排版都没问题,因为以我有限的制作经验发现,英译中的过程起码在段落划分上都是很忠实于原著的,好像没有出现你说的某一个版本一行分三段的问题,即使有也很少,不知道你找的中英两个版本原始数据是不是都是正版没经过编辑9 m4 x4 Y0 ^/ O7 E; z
) H2 ~" h9 P. h% l, A
如果都是正版还出现大量这种情况,那。。。好像就只能“再创作”了,人工校对中英段落对照,那挺累啊4 H* g* b3 Z4 d0 L* v
7 K- L2 w: M: G |
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有账号?免费注册
x
|
 楼主: 5dhtml


 发表于 2018-10-31 10:44:38